大模型与知识产权:从创造、确权、维权全生命周期出发的领域实践
知识产权(IP)是一个把「法律、技术与科学」深度缠绕在一起的领域。专利、软件著作权(代码、GUI)、商标(Logo,天然多模态)等不同客体,各自承载着技术事实与法律权利;它知识密集、强结构、强规范。这种交织恰恰带来了一个有意思的双向机会:
-
向「法律」看:知识产权本身就是一套较为成熟的法律体系,可以作为 AI for Law 的一个高价值切入点——专利审查、侵权判定、赔偿计算、法律问答,都是真实且高频的法律任务。
-
向「技术与科学」看:专利是人类创新最大规模、最结构化的技术记录之一。专利数据天然是 AI for Science / AI for Technology 的优质语料——用它来生成科学 idea、抽取技术特征、组织技术演进,价值不亚于论文。
本文想把我们 Taibao-IP 团队对「大模型 × IP」的整体思路讲清楚,并用几篇具体的论文,说明大模型如何与这个垂域结合、在每个真实任务上能做到什么、还差什么。
一、我们怎么看这个垂直领域:两条主线
我们把「大模型 × IP」拆成两条相互咬合的主线。
应用端,对应 IP 全生命周期的三个动作:创造 → 确权 → 维权。
-
创造(Creation):基于海量专利/文献,产生新颖 idea 与发明,进而生成专利文本。
-
确权(Patentability):评估专利性(新颖性、创造性、实用性),完成专利检索与相似性判断。
-
维权(Enforcement):侵权判定、赔偿计算、法律相关问答等贴近诉讼的任务。
模型/算法端,对应支撑上述应用的四种核心能力:知识注入、生成、评估、判别。
这两条线不是并列清单,而是一张表:
每个应用任务,背后都由若干模型能力支撑。IPBench 的任务分层图,正好可以看作这张表的一个具象化——它把 IP 任务分成信息处理、逻辑推理、判别评估、创造生成四个认知层级。
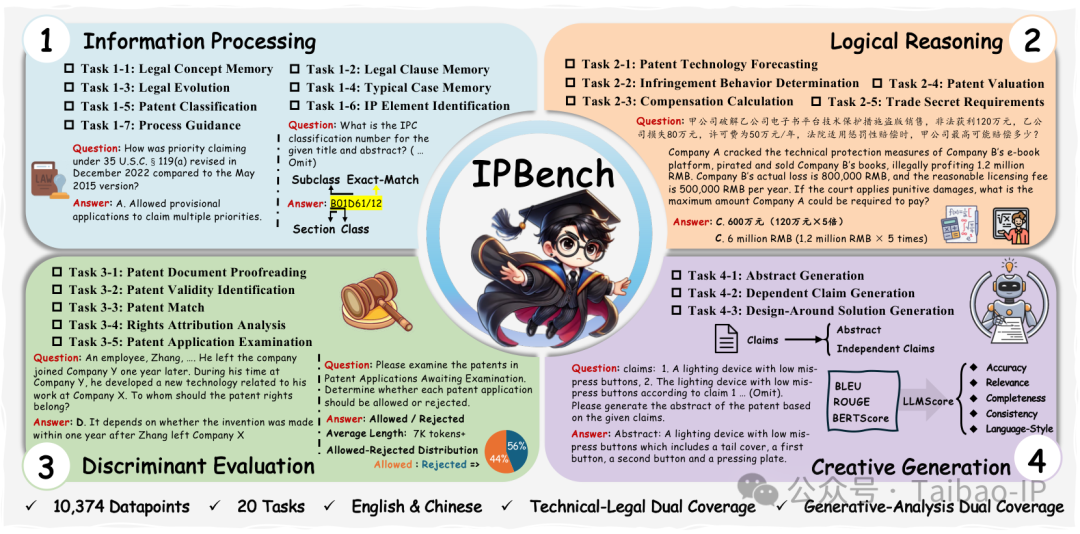
下面我们按这个「双主线」框架,把目前团队和领域的工作串起来讲。
二、创造:用专利数据驱动技术发现
创造端最上游的任务是「idea generation」——给定研究主题,产出新颖、可行、有区分度的想法。这件事的难点很「知识产权」:一个 idea 值不值钱,取决于它离已有先验技术(prior art)有多远,即新颖性。这一方向上已有不少工作(如 SciPIP 和 ResearchAgent 等),但大多沿用「静态检索一批文献 → 一次性生成 idea」的范式,容易陷入信息茧房、产出同质化。
我们的 FlowPIE 换了思路,把 idea 生成做成一个「测试时(test-time)的"思想进化"过程」:用受 GFlowNets 启发的 flow-guided MCTS 在专利文献图谱上动态探索(idea 质量反过来引导下一步检索),再对 idea 种群施加交叉、变异等进化算子,全程由一个基于 LLM 的生成式奖励模型(GRM)对 novelty、feasibility 打分驱动。
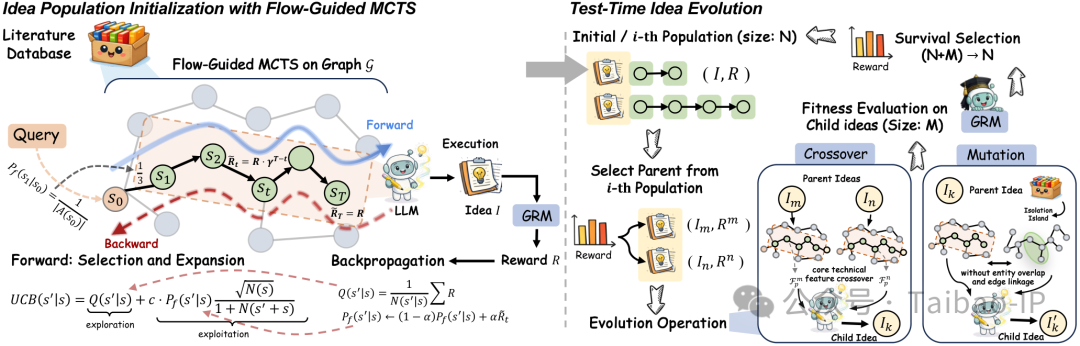
值得强调的领域选择是:FlowPIE 用「专利作为文献源」——专利权利要求(Claims)结构清晰、范围明确、易抽取,能减少陈述歧义。这是"专利数据服务 AI for Science"的一个直接例证。
三、确权:把交底书翻译成规范的专利文本
创造出 idea 后,要落地成一份能提交、能授权的专利——这是确权端最硬核的生成任务,也是「法律与技术交织」最紧的地方。专利申请的本质,是把发明人模糊、发散的技术交底,凝练成一组层层嵌套的权利要求,再经受审查员以新颖性、创造性、实用性的逐条审查。
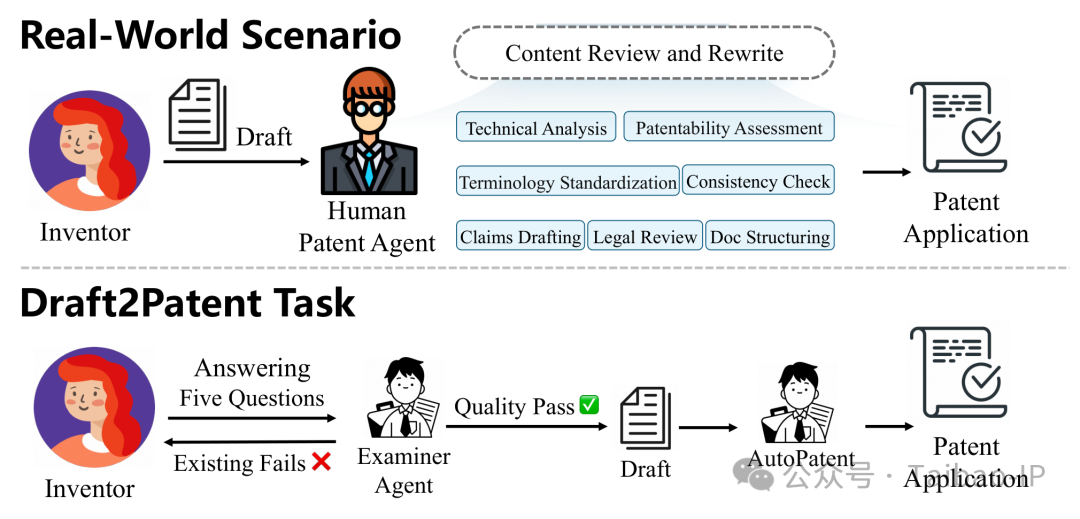
我们的 AutoPatent 面向这个真实场景。我们提出 Draft2Patent 任务和 D2P 基准,要求模型从交底书生成平均长度超过 17K token 的完整专利。这个任务暴露了大模型在专利长文档生成上的两个真实困难:
-
长度与结构:详细说明平均超 14K token,占全文 80% 以上,单次生成扛不住。
-
高分幻觉:直接端到端 SFT,BLEU/ROUGE 分数很漂亮,但「人工评估和我们提出的 IRR(逆重复率)指标」戳穿了它——这些专利充斥机械重复,IRR 低到 49(真实专利约 91),权利要求段落退化成无意义循环。n-gram 指标对重复的偏好制造了能力假象。
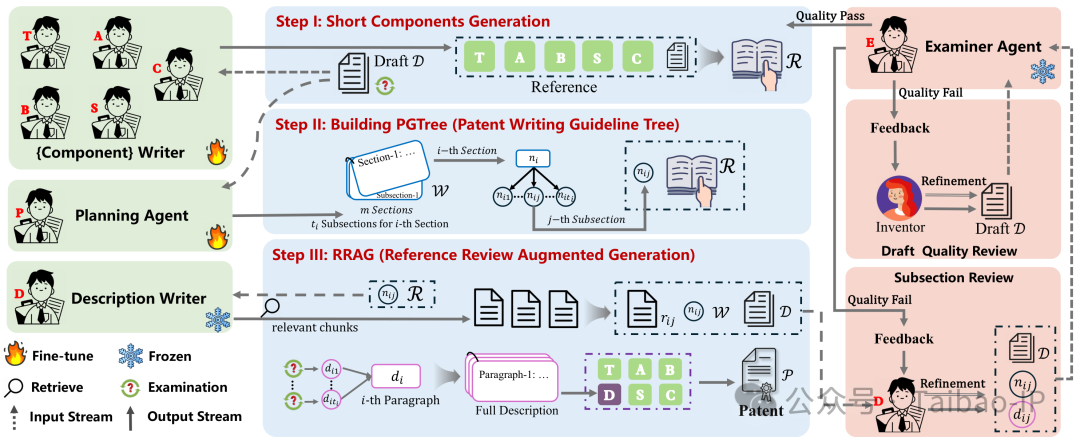
AutoPatent 的解法,是把人类专利代理的工作方式搬进一套「多智能体协作流程」:
-
PGTree(专利写作指引树):planner agent 把详细说明拆成两层多叉大纲,化整为零;
-
RRAG(参考-审查-增强生成):description writer 按大纲逐段写,配合 examiner agent——它在每段写完后主动介入、给修改意见、反复迭代直到通过,把「审查员」内化进写作循环;
-
短组件(标题、摘要、权利要求等)由专门的 writer agent 分别生成,兼顾各部分迥异的文体。
效果很说明问题:Qwen2.5-7B 套上 AutoPatent 框架,在客观指标和人工评估上都超过了 GPT-4o、Qwen2.5-72B、LLaMA3.1-70B 这些更大的模型,重复错误也大幅下降。
专利长文档生成不是「模型够大就行」,而是「流程够像专业代理人才行」。把审查闭环、结构化大纲、分工写作这些领域工作流显式建模,7B 也能打过 70B。
四、专利审查:把「确权」建模成审查员与申请人的多轮博弈
专利能否授权,最终取决于审查(examination)这一关。审查员依据 MPEP 等规范,结合检索到的对比文件,判断一项申请是否满足新颖性、创造性、实用性,并下发审查意见(Office Action, OA);申请人则可以提交答辩意见(rebuttal)据理力争,往复多轮直至终局。这是确权环节中「法律推理与技术新颖性判断」结合得最紧密的地方。
已有工作大多把专利审查当成一个「判别式分类」问题:HUPD 做「接受/驳回」的二分类预测,PANORAMA、PEDANTIC、PILOT-Bench 等进一步细化到驳回理由、法条(如 §102/§103)的识别。这些工作很有价值,但都停在「对最终版本做一次性、静态判断」,丢掉了审查真正的精髓——它是一个动态的、多轮的、对抗性的「论证—答辩」过程,很像学术论文的 peer review 与 rebuttal。
我们的 PatRe 正是针对这一点:它是首个覆盖专利审查「全流程」的基准,把审查重新建模为审查员 OA 生成与申请人答辩生成的多轮交互,包含 480 个真实案例、覆盖全部 8 个 IPC 大类,并配套法条、claim 演进、引用对比文件等细粒度标注。
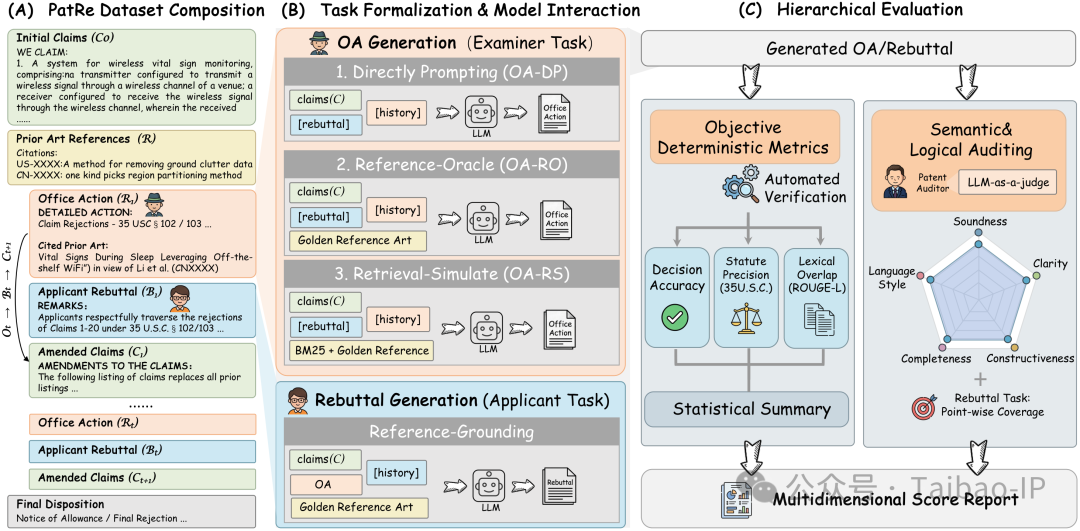
PatRe 在任务设计上很贴合真实审查:OA 生成区分了直接生成、给定 oracle 对比文件、以及 BM25 检索模拟三种信息条件——后者要求模型先从带噪候选中辨别出真正相关的 prior art,再据此作出新颖性判断,这正是审查员每天在做的事。实验也揭示了几个有领域意义的现象:闭源与开源模型存在明显差距;「主动审查(OA)」与「被动答辩(rebuttal)」之间存在任务不对称性——模型在两端的能力并不对等。这说明 LLM 距离真正胜任专利审查的法律推理与新颖性判断,还有不小距离。
五、确权与维权的共同内核:判别「技术相似性」
确权里的专利检索、维权里的侵权判定,乃至上一节审查中的新颖性判断,看似多件事,模型层面却共享同一个内核,即判断两份技术文本到底有多相似。这是 IP 领域最普遍、也最被低估的能力,也是 AI for Law 在 IP 上的硬骨头。
我们在 MoZIP 里最早把它单独立成任务:PatentMatch 中给定一篇专利摘要,从候选中选出技术上真正相似的那篇。我们刻意把题目设计得很「刁」:正确答案在词面重叠(BM25)上排名低、语义向量上排名高,干扰项反过来。这样才能测出模型是否真的「理解」发明,而非靠关键词蒙混。结果是:除 ChatGPT 外,几乎所有模型准确率不到 30%,个别甚至低于随机猜测。MoZIP 同时是首个覆盖 9 种语言的 IP 基准,并配套了首个 IP 垂域多语言模型 MoZi(三阶段在专利/通用/IP 指令上微调)。
这条线上也有不少同行工作从不同侧面切入:PatentEval 关注权利要求/摘要生成的细粒度错误评估,IPEval 构建了 IP 领域的法律考试评估基准,PatentEdits、Patent-CR 研究权利要求的版本演进与修订。它们与 MoZIP/PatentMatch 一道,勾勒出「判别」在 IP 各任务中的普遍性。
到了 IPBench,我们把这种「判别」能力放进更完整的图景。IPBench 是首个综合性 IP 基准——8 种 IP 机制、20 个任务、10,374 条双语数据,依据 Webb 的 Depth-of-Knowledge 理论分成四个认知层级。几个直接面向应用的发现:
-
专利分类(IPC/CPC)极难:把一篇专利精确落到层级化技术分类体系上,最好的 DeepSeek-R1 的 Exact Match 也只有 10.8%,多个模型 0.0%——这是确权与专利管理的底层基础设施,却是当前大模型最弱的一环。
-
维权类任务需要推理:在赔偿计算(Task 2-3)上,推理模型 DeepSeek-R1 显著超过同门 chat 模型 DeepSeek-V3 约 5.7%——因为它要的不只是判别,还要「算清赔多少」的数值推理。这提示维权场景需要 System-1 与 System-2 的合流。
-
跨法域差异真实存在:DeepSeek-V3 在中文子集最强,GPT-4o 在英文子集最强——IP 强烈依赖具体国家/地区的法律体系,模型需要在推理时适配。这正是 AI for Law 在 IP 上的独特挑战。
创造的「新颖性」、确权的「专利性/检索」、维权的「侵权判定」,在模型层面都落到同一个技术相似性/新颖性判别问题上。与其为每个任务各训一个垂域模型,不如把这种判别能力当作可复用的基座来建设。
六、一个绕不开的领域问题:怎么评估?
把上面的任务串起来,会发现评估本身是 IP 领域一个需要专门考虑的问题。IP 任务的输出往往是「权利」而非单纯的「事实」,对错需要专家判断,通用指标常常不够用。我们在不同工作中也相应采用了不同的评估方式:
-
AutoPatent 的 IRR:BLEU/ROUGE 容易被重复文本骗高分,因此用逆重复率来识别长专利生成的退化;
-
IPBench 的 LLMScore:摘要/权利要求生成上传统指标与人类判断相关性偏低,故采用基于 LLM-as-a-judge 的多维度评估,其与人工评分的相关性高于 BLEU/ROUGE/BERTScore;
-
PatRe 与 FlowPIE:分别用分层的客观指标 + LLM auditor,以及 GRM 新颖性/可行性评判,来支撑审查与创造任务。
在 IP 领域,评估能力与生成能力同等重要,可靠的评估/判别往往是生成质量的前提。这也是我们把「评估」和「判别」列为模型端核心能力的原因。
七、还有很多研究方向可以探索
沿着「创造 / 确权 / 维权 × 知识 / 生成 / 评估 / 判别」这张表往下看,仍有大量空白,且每一块都很有领域特色:
-
多模态是最大的待开发区。IP 天生多模态:商标就是 Logo(图形近似判别直接决定侵权),专利附图承载了文字写不全的技术细节,软著涉及代码与 GUI(InteractWeb-Bench)。专利附图的理解与解释生成(如 PatentLMM 一类多模态尝试 [6])、商标图形近似判别,都是自然且急需的延伸。
-
维权侧整体欠开发。法律 QA、侵权抗辩等,至今缺乏像 D2P 那样高质量、贴近真实场景的数据与框架——而这恰是 IP 离产业最近、最能体现 AI for Law 价值的一端。
-
垂域模型的正确打开方式仍待回答。MoZi、IPBench 的经验提示:单纯灌 IP 语料做垂域微调,提升的主要是"记忆/信息处理",而 IP 的硬骨头在判别、推理、生成。如何在注入领域知识的同时不牺牲通用与推理能力,是垂域大模型的共性难题,在 IP 上尤为突出。
八、小结
我们对这个方向的理解可以概括为:大模型 × 知识产权,不是再做一个「懂 IP 的聊天模型」,而是围绕「创造、确权、维权」完整 IP 生命周期的三个真实核心动作,把生成、评估、判别这些能力,按 IP 的领域工作流组织起来。 而 IP 法律、技术、科学交织的特性,又让它同时成为 AI for Law(基于知识产权法律体系)和技术发现 / AI for Science 的天然交汇点。
我们的几篇工作各自落在这张表的不同格子里——FlowPIE 在创造端用专利数据驱动新颖 idea 的进化,AutoPatent 在确权端做完整专利的生成,PatRe 把专利审查建模为多轮博弈,MoZIP/IPBench 在判别与评估端搭基准、立任务体系。同时 HUPD、PANORAMA、PatentEval、IPEval、Pap2Pat 等则从分类、抽取、生成、修订等不同侧面共同充实了这张地图。它们共同指向同一个判断:在 IP 这种强结构、强规范、技术与法律交织的领域,领域任务的拆解、领域工作流的建模、领域评估的设计,比单纯堆参数更能决定大模型能否真正用起来。
与此同时,我们未来会继续在「大模型 × 知识产权」这个方向持续探索,架起人工智能与知识产权以及法律、技术与科学之间的桥梁。我们的目标不是破坏与改变知识产权制度或替代任何从业人员,而是基于人工智能赋能行业,提升知识产权的「法律保护」,「技术创新效率」与「高质量技术判别」等能力。希望将知识产权相关服务迈向 IP Intelligence 的新智能化水平。
竞赛成果方面,团队在该方向与 DUT-IR 合作已获包括 2024 年挑战杯国家级银奖和2025年挑战杯国家级一等奖在内的「10 项国家级」和「13 项省级奖项」。
科研探索方面,后续将在公众号「Taibao-IP」持续介绍大模型 + 知识产权的团队与领域工作。欢迎您的持续关注。
Taibao-IP 团队简介:SIAT-NLP 博士生王琪尧与 DUT-IR 合作的 LLM + 知识产权方向研究小组。
Contact
There may be some errors present. If you find any, please feel free to contact me at wangqiyao25@mails.ucas.ac.cn. I would appreciate it!