大模型会不会做知识产权工作,不能只看它能不能回答几道题。
知识产权任务既涉及法律规则,也涉及技术事实、证据组织和程序推进。从知识咨询到综合实践,再到专利审查意见与答复,任务形态在变化,对模型的要求也在变化。一个更基础的问题是:我们应当如何准确、可复现地评价大模型在知识产权领域的能力?
今天,Taibao IP Intelligence 研究团队主页正式上线。作为网站 Resources & Tools 板块的精选资源,IPIntelligenceArena 汇集团队已公开的知识产权大模型评测研究,为相关论文、代码、数据和项目页面提供统一入口。后续将持续更新团队在知识产权智能的可信评测的相关工作。
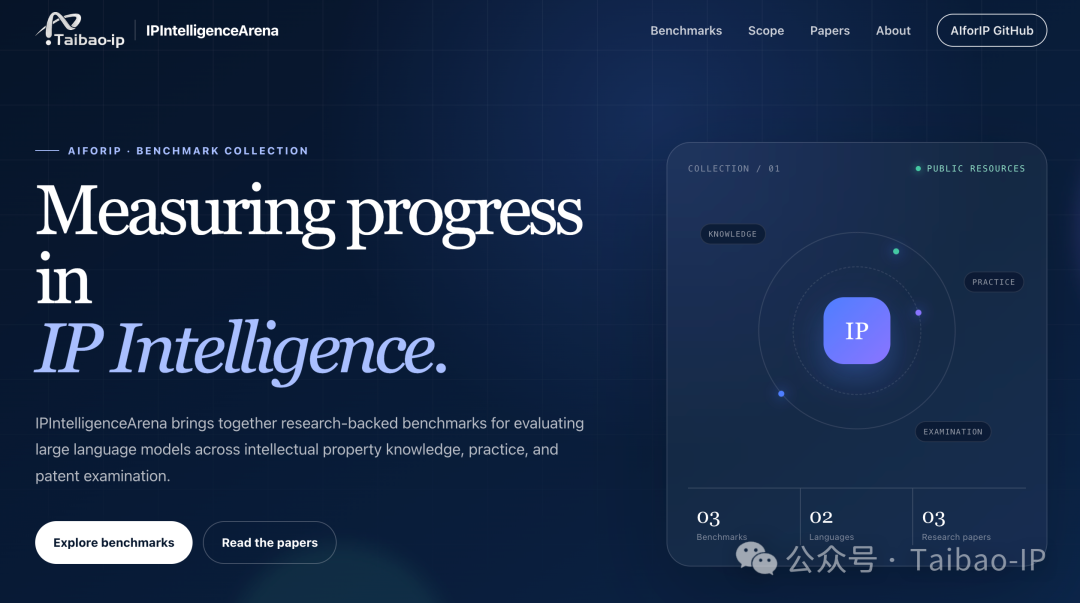
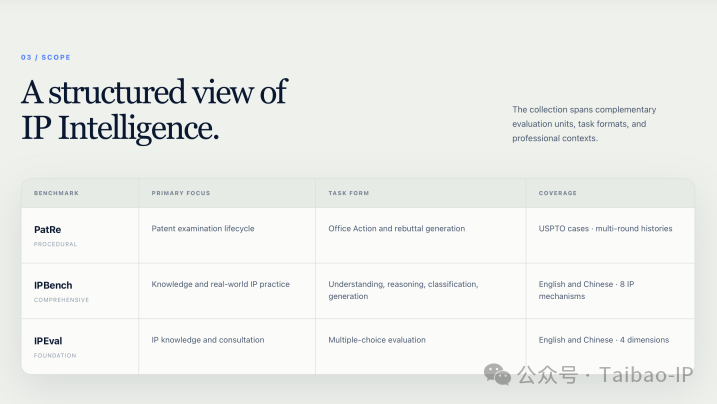
当前平台收录 IPEval、IPBench 与 PatRe 三项 benchmark,覆盖中英文两种语言,并从知识与咨询、综合知识产权实践和专利审查过程三个层面呈现大模型能力。
平台主页:https://iparena.wangqiyao.me/
01 |RESEARCH PATH
一个入口,看见三项研究的能力递进
IPIntelligenceArena 不是将三项工作简单放在一起。按发布时间回看,它们形成了一条清晰的研究路径:
「IPEval」从中英双语知识产权知识与代理咨询出发,回答模型“是否理解并能够应用基本规则”;
「IPBench」将评价扩展到更广泛的法律技术任务考察信息处理、逻辑推理、判别评价和创造生成;
「PatRe」进一步进入多轮专利审查过程,要求模型在具体申请文件、审查意见和对比文献构成的上下文中,分别完成审查意见与申请人答复生成。
三项 benchmark 的评价对象并不相同,也不适合被简化为一张总分榜。它们更像三个相互衔接的观察窗口:从知识,到任务,再到程序,逐步呈现知识产权智能的不同层次。
02 |PATENT EXAMINATION
PatRe:把专利审查还原为持续的意见与答复
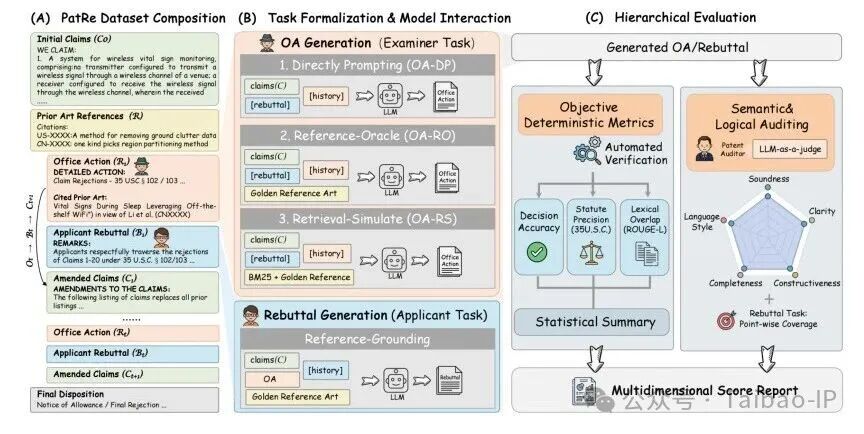
专利审查不是一次性的文本判断。审查员需要结合权利要求和对比文件提出审查意见,申请人则需要理解驳回理由并作出回应;随着程序推进,双方意见还会继续影响后续轮次。
PatRe将这一过程建模为 Office Action 生成与 Rebuttal 生成两类任务,基于 480 个真实案例和 1,075 份 Office Action,设置直接生成、给定审查员参考文献和模拟检索等不同实验条件。
与只判断“是否新颖”或抽取某个字段的静态任务相比,PatRe 关注的是模型能否在明确角色、具体材料和多轮历史中形成完整、可回应的专业文本。它把评价从单点答案推进到更接近真实审查程序的文档生成过程。
相关资源
项目主页:https://patre.wangqiyao.me/
论文:https://arxiv.org/abs/2605.03571
代码与数据:https://github.com/AIforIP/PatRe
03 |KNOWLEDGE & PRACTICE
IPBench:从知识记忆走向综合知识产权实践
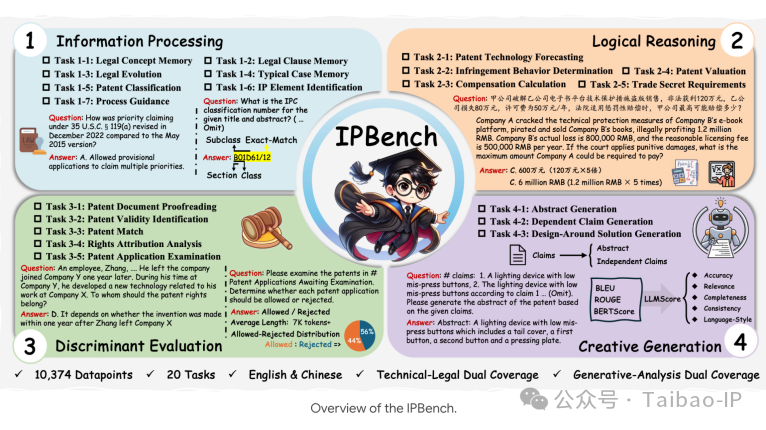
真实的知识产权任务很少只依赖一种能力。模型既要读懂技术文本和法律规则,也要进行比较、判断、推理与生成。
IPBench 基于认知深度理论构建四层任务体系,包含 10,374 条数据、20 项任务,覆盖 8 类知识产权机制。任务横跨技术与法律内容,从信息处理、逻辑推理、判别评价和创造生成四个层次考察模型。
这一设计使评价不再停留于“记住了多少知识”,而是进一步观察模型能否在不同任务形式下理解、分析和处理知识产权信息。IPBench 已被 ACL 2026 Findings 接收。
相关资源
项目主页:https://ipbench.wangqiyao.me/
论文:https://arxiv.org/abs/2504.15524
代码:https://github.com/IPBench/IPBench
数据:
https://huggingface.co/datasets/IPBench/IPBench
04 |BILINGUAL FOUNDATION
IPEval:从中英双语知识与咨询建立评价起点
在进入复杂任务以前,模型首先需要理解知识产权制度,并能够在咨询语境中正确应用相关知识。
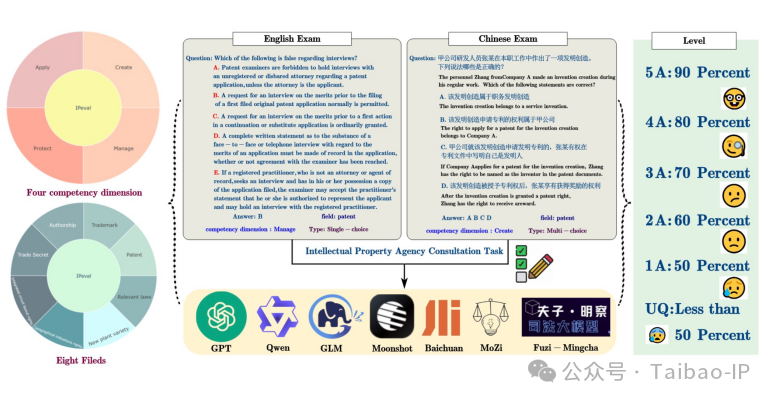
IPEval 收录 2,657 道中英文选择题,覆盖知识产权创造、运用、保护和管理四个能力维度,用于评价大模型在知识产权代理与咨询场景中的知识理解和应用能力。
作为三项工作中最早发布的 benchmark,IPEval 提供了一个清晰、可重复的基础评价起点,也为后续从知识考察走向综合任务与程序任务奠定了基础。
相关资源
项目主页:https://ipeval.wangqiyao.me/
论文:https://arxiv.org/abs/2406.12386
代码:https://github.com/QiYao-Wang/IPEval
数据:
https://huggingface.co/datasets/Mathsion/IPEval
05 |WHY A COLLECTION
为什么要把这些 benchmark 放在一起?
当研究分散在不同论文、项目页面和代码库中,我们容易只看到单项结果,却不容易看清整个领域正在评价什么。
IPIntelligenceArena 提供的第一个价值,是让不同层次的任务进入同一视野:
— 评价单元 从单道问题,扩展到多类型实践任务,再进入多轮审查文档;
— 能力要求 从知识记忆与规则应用,扩展到理解、推理、判别和生成;
— 任务语境 从相对独立的问答,逐步进入带有角色、材料和程序历史的专业过程。
这条路径也提示我们:衡量“IP Intelligence”,不能只问模型答对了多少题,还要继续追问它依据什么作出判断、能否处理具体材料、能否在程序约束下完成可核验的专业任务。
IPIntelligenceArena 当前聚焦于已经公开的研究成果。平台中的每项 benchmark 均链接至相应论文与公开资源,便于研究者了解任务设计、复现实验并进一步讨论模型能力边界。
06 |VISIT
访问 IPIntelligenceArena
欢迎访问 IPIntelligenceArena,以及 IPEval、IPBench 与 PatRe 项目页面、论文、代码和已公开数据资源。
平台主页:https://iparena.wangqiyao.me/
研究主页:https://lab.wangqiyao.me/
GitHub:https://github.com/AIforIP
资源入口:
https://lab.wangqiyao.me/resources.html
Taibao-IP 团队简介:SIAT-NLP 博士生王琪尧与 DUT-IR 合作的 LLM + 知识产权方向研究小组。
来源:李鉴航
审核:王琪尧
Contact
There may be some errors present. If you find any, please feel free to contact me at wangqiyao25@mails.ucas.ac.cn. I would appreciate it!